Частная AI-платформа для инженерной компании на 200 сотрудников
Мы разработали и развернули для немецкой инженерной компании частную AI-платформу на её собственном сервере: наш продукт «Люмен» как общее рабочее пространство, модели Qwen3 на четырёх GPU NVIDIA L40S, поиск по архиву проектов за 23 года, расшифровку встреч и помощника для кода. Платформа заменила облачные подписки на 14 000 € в месяц, окупила оборудование за 3,5 месяца, а к третьему месяцу работы ею пользовались 94 % сотрудников.
- срок проекта
- 3 месяца
- функциональных модулей
- 8
- этапов разработки
- 6
- ключевых технологий
- 10
02 — Контекст
Задача проекта
Исходная ситуация, ограничения и проблемы, которые должна была решить новая система.
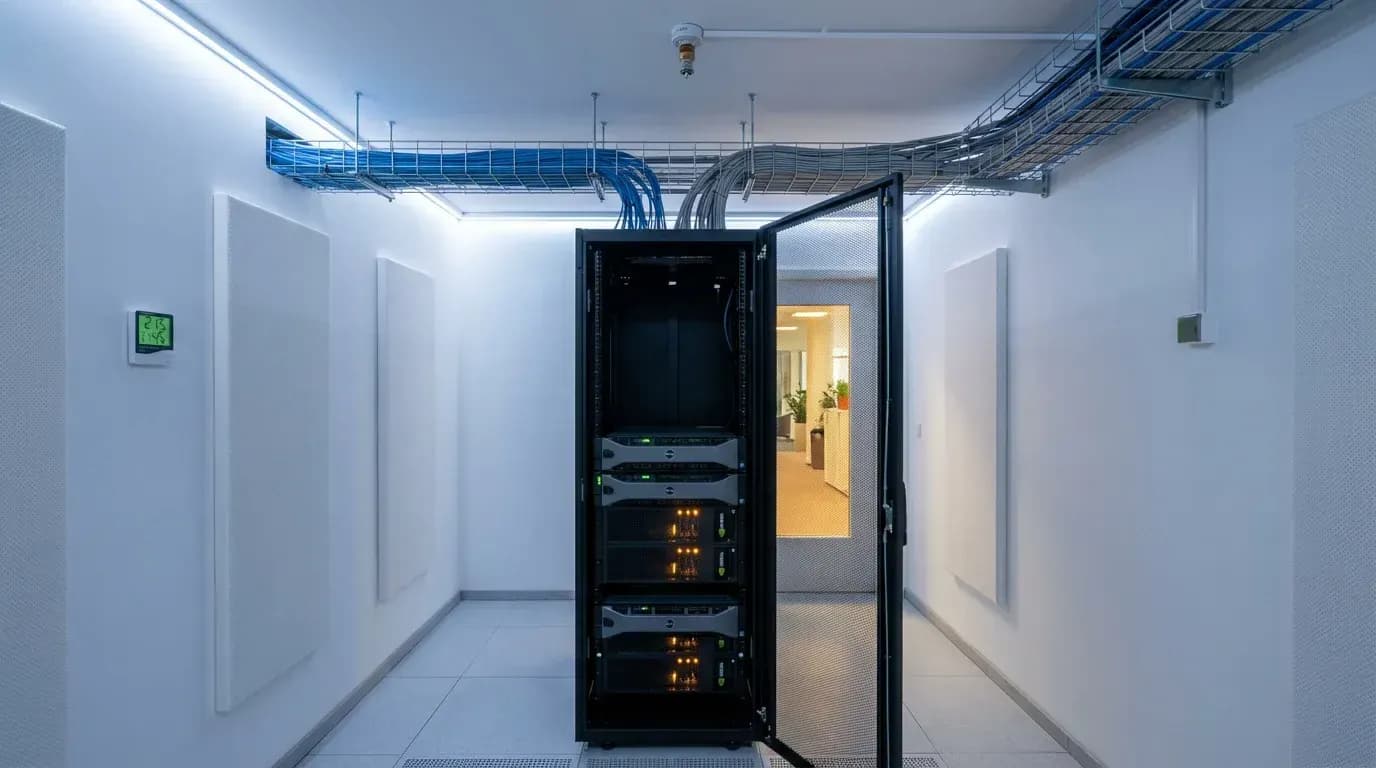
Немецкая компания по проектированию строительных конструкций — 200 сотрудников в двух офисах — пришла к нам с проблемой, которая не имела отношения к инженерии. Сотрудники уже пользовались ИИ, но небезопасно: около 80 человек вставляли данные клиентов в личные аккаунты ChatGPT. ИТ-отдел одобрил ChatGPT Enterprise для части команд, GitHub Copilot для разработчиков и разные сервисы расшифровки для руководителей проектов.
Расходы на облачный ИИ дошли до 14 000 € в месяц, и никто централизованно не видел, какие данные уходят из сети. При этом NDA по большинству инфраструктурных проектов прямо запрещают передавать проектные данные сторонним облачным сервисам, а сверху действуют немецкие требования к защите данных.
Компании нужен был ИИ для всех: чат, поиск по документам, помощь с кодом, расшифровка встреч. Но всё должно было работать на её собственном оборудовании, и ни один байт данных не должен был покидать сеть.
Данные клиентов в личном ChatGPT
Около 80 сотрудников вставляли данные клиентов в личные аккаунты ChatGPT, хотя клиентские NDA прямо запрещали передавать проектные данные в сторонние облака. Компания не могла это ни проконтролировать, ни остановить.
Разрозненные подписки на 14 000 € в месяц
ChatGPT Enterprise, GitHub Copilot, сервисы расшифровки и оплата API у разных поставщиков. Деньги уходили каждый месяц и росли с числом мест, а единой точки контроля над данными не было.
Опыт 23 лет — только в головах
Расчёты, геологические отчёты и акты обследований лежали на общем диске с поиском только по имени файла. Ключевые знания о проектах держали в голове старшие инженеры, и с уходом сотрудника они уходили вместе с ним.
03 — Возможности
Что делает система
Ключевые сценарии и рабочие модули, собранные в единую систему.
Сервер инференса на четырёх GPU
GPU 1 и 2 обслуживают основную модель Qwen3-32B в FP16 с тензорным параллелизмом через vLLM. На GPU 3 работает быстрая Qwen3-8B, а Qwen2.5-Coder-32B подгружается по запросу. GPU 4 отдан Whisper, модели эмбеддингов и лёгкой Qwen3-4B для форматирования и перевода. Ollama загружает и выгружает модели по нагрузке.
Рабочее пространство «Люмен»
Каждый сотрудник работает в «Люмене» — привычном интерфейсе в духе ChatGPT: диалоги, загрузка файлов, выбор модели. Вход — под рабочей учётной записью через Keycloak и Active Directory. История хранится в локальной PostgreSQL: её можно искать и делиться диалогами с коллегами. ИТ-отдел видит статистику использования, но не содержание переписки.
Шаблоны для отделов
Для каждого отдела мы подготовили шаблоны промптов с нужным контекстом. У конструкторов — ссылки на немецкие строительные нормы и принятые в компании обозначения, у руководителей проектов — оценка сроков и планирование ресурсов, у отдела развития — стандарты коммерческих предложений и переписки с клиентами. Сотрудники могут менять шаблоны и создавать свои.
Поиск по архиву проектов за 23 года
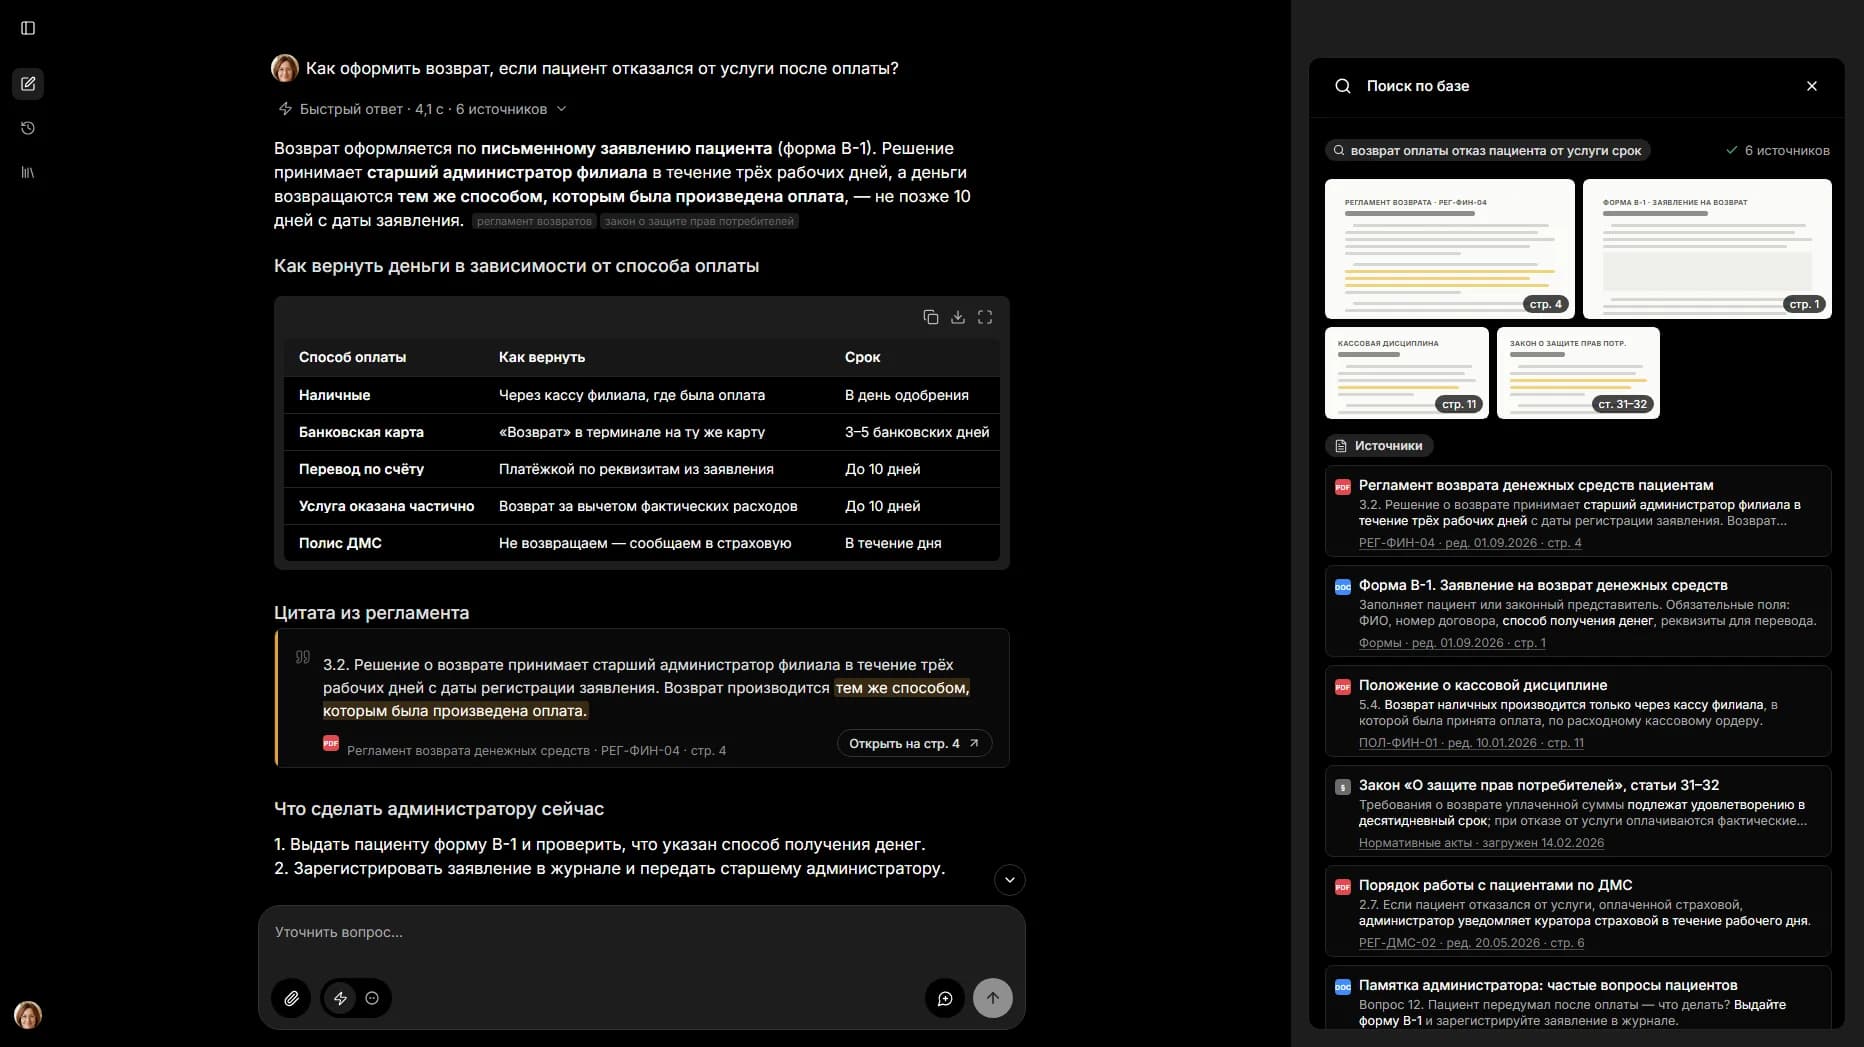
В локальной векторной базе Qdrant проиндексированы около 340 000 документов — 2,8 млн страниц расчётов, геологических отчётов, актов обследований, предложений и технических записок. Инженер спрашивает, какие допущения по несущей способности закладывали для путепровода в Мангейме в 2019 году, и получает ответ со ссылками на исходные файлы. Нормы DIN и Еврокоды тоже доступны для вопросов обычным языком.
Индексация и права доступа
Каждую ночь пакетная задача забирает новые и изменённые файлы с общего диска, а приоритетные каталоги индексируются сразу после изменений. Права в поиске повторяют права на папки: инженер без доступа к папке конфиденциального клиента не получит её документы через RAG — даже косвенно, через пересказ в ответе модели.
Расшифровка и протоколы встреч
Whisper работает локально и расшифровывает записи на немецком и английском. Руководитель проекта загружает запись через веб-интерфейс и через несколько минут получает расшифровку с таймкодами. Qwen3-8B готовит по ней протокол в шаблоне компании: поручения, принятые решения и открытые вопросы. Облачная расшифровка за 600 € в месяц больше не нужна.
Черновики отчётов
Инженер описывает задачу — например, предварительное заключение по парковке в Дюссельдорфе на основе обследования прошлой недели. Система берёт данные из базы знаний, применяет шаблон отчёта компании и готовит первый черновик. Итоговый текст инженер проверяет и правит сам, но работа начинается не с чистого листа и обычно экономит 2–3 часа на отчёт.
Помощник программиста
Команда разработки — около 30 человек — пишет на Python скрипты расчётов, на MATLAB моделирование и внутренние инструменты. Qwen2.5-Coder-32B в квантовании INT8 дополняет код, помогает с отладкой и документацией. Репозиторий компании проиндексирован в RAG, поэтому модель знает внутренние библиотеки и соглашения. Работают с ней в том же интерфейсе.
04 — Архитектура
Технологический стек
Технологии выбраны под нагрузку, интеграции и дальнейшее развитие продукта.
Зачем в проекте · 01 / 10
Qwen3-32B и Qwen3-8B
Открытые модели, которые можно запускать на своём сервере. Qwen3-32B берёт сложную аналитику, разбор расчётов и длинные отчёты на уровне, сопоставимом с GPT-4. Qwen3-8B отвечает на повседневные вопросы быстрее чем за 2 секунды. Сотрудник выбирает модель под задачу.
- RAG
05 — Процесс
Как шла разработка
Последовательность работ от исследования задачи до запуска и проверки результата.
Сервер и модели
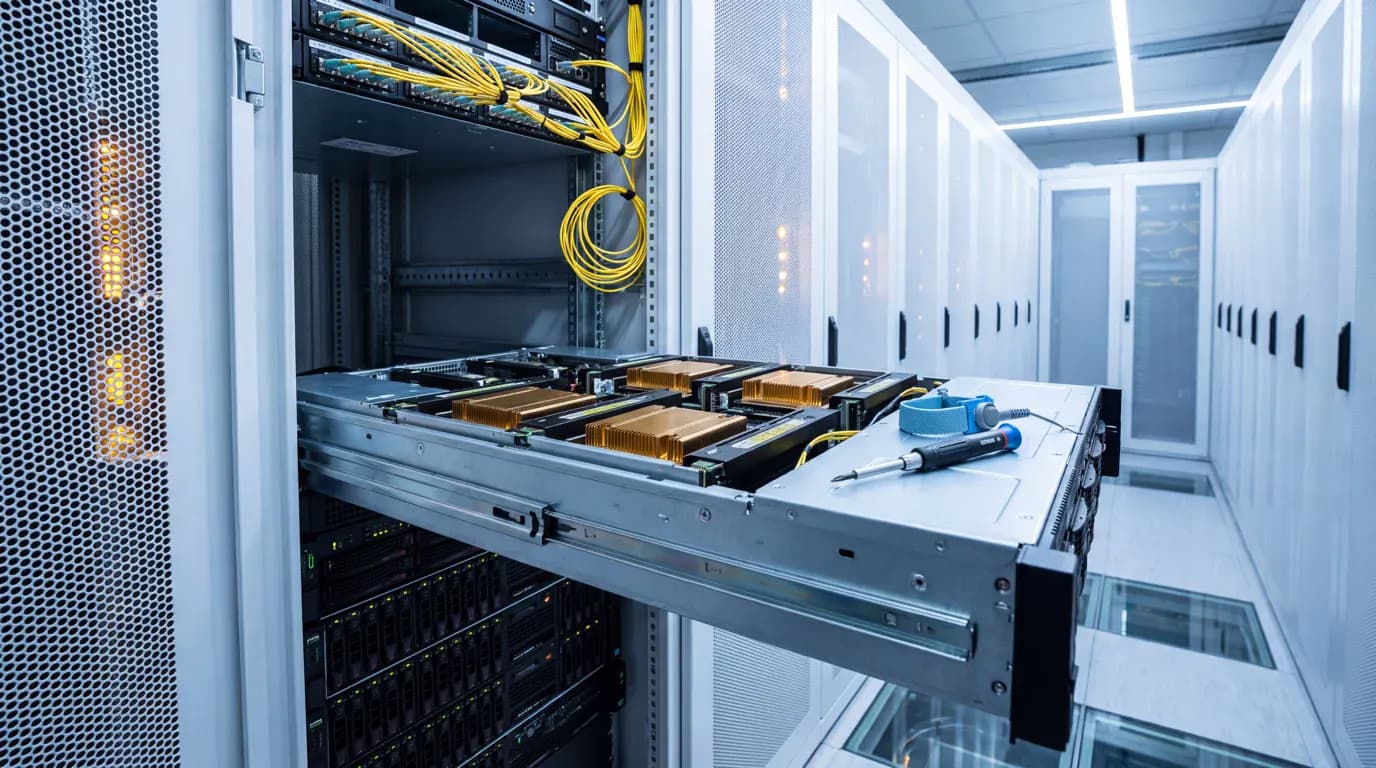
Собрали сервер Supermicro с четырьмя NVIDIA L40S, двумя Xeon, 256 ГБ памяти и 4 ТБ NVMe, развернули vLLM, Ollama и Docker и запустили Qwen3-32B и Qwen3-8B. Серверная компании приняла его без переделок: под нагрузкой сервер потребляет около 2 кВт.
Общее рабочее пространство
Развернули «Люмен», подключили единый вход через Keycloak и Active Directory, настроили выбор моделей, историю диалогов и шаблоны промптов для каждого отдела.
База знаний
Проиндексировали в Qdrant архив проектов за 23 года, нормы DIN и Еврокоды, шаблоны коммерческих предложений. Сделали поиск с цитатами и ссылками на источники и перенесли в него права доступа к папкам.
Инструменты для работы
Добавили локальную расшифровку встреч на Whisper, протоколы, черновики отчётов и помощника для кода на Qwen2.5-Coder-32B. Все четыре компонента платформы мы сдали за три месяца.
«Чемпионы» в отделах
Запуск начали с 30 «чемпионов» — двух-трёх энтузиастов из каждого отдела. На практических занятиях каждый разобрал свои задачи: конструктор — поиск по прошлым расчётам, руководитель проекта — протоколы встреч, менеджер по развитию — коммерческие предложения. Чемпионы стали внутренней поддержкой для коллег.
Доступ для всех и встраивание в работу
Открыли доступ всем 200 сотрудникам: вход под рабочей учётной записью, 10-минутный интерактивный курс и библиотека промптов по отделам. Затем добавили платформу в чек-лист запуска проекта, ссылки в систему управления проектами и горячие клавиши. Активное использование выросло с 40 % в первый месяц до 78 % во второй и 94 % к третьему.
06 — Итог
Результаты
Что создано в рамках проекта: рабочий контур, реализованные возможности и подтверждённые факты.
- в месяц больше не уходят на облачный ИИ
- 14 000 €
- окупаемость сервера за 48 000 €
- 3,5 месяца
- сотрудников пользуются платформой каждый месяц
- 94 %
- чистая экономия за первый год
- 115 000 €
Платформа полностью заменила облачные AI-подписки и API на 14 000 € в месяц. Оборудование за 48 000 € при расходах около 400 € в месяц на электричество и обслуживание окупилось за 3,5 месяца, а чистая экономия за первый год после вычета стоимости сервера составила 115 000 €. В отличие от подписок с оплатой за место, локальная платформа обслуживает всех 200 сотрудников с нулевой стоимостью запроса: ещё 50 человек в следующем году не добавят ни евро.
Система обрабатывает больше 12 000 запросов в неделю и в утренний пик выдерживает 40–50 одновременных запросов без заметного роста задержки. Запросы распределились так: общие вопросы и черновики — 38 %, поиск по базе знаний — 27 %, документы и отчёты — 18 %, код — 11 %, расшифровка встреч — 6 %. С момента запуска не было ни одного инцидента с утечкой данных, а ИТ-отдел на ежеквартальном аудите подтвердил соответствие клиентским NDA и немецким требованиям к защите данных.
Самым ценным оказался поиск по базе знаний. Старших инженеров реже отвлекают вопросами о прошлых проектах, а новые сотрудники с первого дня работают с опытом компании за 23 года. По оценке самой компании, это экономит около 15 часов в месяц на инженера. Оценка основана на опросе и, скорее всего, завышена, но даже половина этой цифры на 120 инженеров многократно перекрывает стоимость сервера.
Детали проекта
Почему кейс без имени клиента
Название заказчика мы не раскрываем. Это немецкая компания по проектированию строительных конструкций на 200 сотрудников, и NDA с её собственными клиентами по инфраструктурным проектам распространяются на всё, что связано с проектными данными. Поэтому закрытыми остаются имя компании, названия проектов и всё, что позволяет их вычислить.
При этом мы открыто рассказываем, как устроена платформа: конфигурация сервера, распределение моделей по GPU, устройство поиска по архиву и план запуска по отделам. Рекомендацию заказчика можем передать по запросу после подписания NDA, а то, как такая платформа ляжет на ваши данные и инфраструктуру, разберём на встрече.
FAQ
Вопросы о проекте
Далее
Похожие проекты
Обсудим похожий проект?
Расскажите о задачах вашего бизнеса — предложим архитектуру и оценим сроки


