Локальный клинический ИИ для сети медицинских центров в Чили
Мы развернули клинический ИИ для сети специализированных медицинских центров в Чили — больше 30 клиник в нескольких регионах. Модели работают в собственном дата-центре клиента, и ни один запрос к ним не выходит за периметр клинических данных. Система извлекает сведения из направлений и выписных эпикризов на испанском со ссылкой на источник у каждого поля, а персонал вместо сторонних чат-ботов работает в контролируемом AI-пространстве. Первая задача заработала в продакшене через 12 недель.
- срок проекта
- 12 недель
- функциональных модулей
- 7
- этапов разработки
- 6
- ключевых технологий
- 6
02 — Контекст
Задача проекта
Исходная ситуация, ограничения и проблемы, которые должна была решить новая система.
Сеть хотела применить языковые модели к документам, на которых держатся приём и маршрутизация пациентов: направлениям, выписным эпикризам и диктовкам врачей. Сначала попробовали облачный путь. Проект с внешним AI-провайдером почти два квартала провёл в юридическом согласовании, раскрытии субподрядчиков и оценке рисков поставщика — хотя сама техническая интеграция заняла бы несколько недель.
Дело было не в недостающей подписи. По закону Ley 20.584 медицинская карта пациента (ficha clínica) конфиденциальна, а круг тех, кто вправе её открыть, закрыт и перечислен: сам пациент, лечащие специалисты, суд по конкретному решению и органы здравоохранения при эпидемиологическом расследовании. Провайдера модельного API в этом списке нет, и коммерческий договор его туда не добавит. Аналога американского BAA, которым компания распространяет свой периметр соответствия на подрядчика, в Чили не существует.
Поджимали и сроки. Закон Ley 21.719, опубликованный в декабре 2024 года, вступает в силу 1 декабря 2026-го: появляется надзорное Агентство по защите персональных данных, уведомление об утечке в течение 72 часов, обязанность доказывать соблюдение требований и штрафы до 20 000 UTM. Каждого обработчика данных, подключённого в 2025 году, пришлось бы заново оформлять и защищать перед регулятором. А сотрудники тем временем уже пользовались потребительскими чат-ботами на личных устройствах.
Облачный проект застрял в согласованиях
Почти два квартала ушло на юридическую экспертизу, раскрытие цепочки субподрядчиков и оценку рисков поставщика. Техническая интеграция заняла бы недели, но запуск упирался в то, что подрядчику по закону нельзя дать доступ к медкартам.
Новый закон о данных на подходе
С 1 декабря 2026 года Ley 21.719 вводит надзор, уведомление об утечках за 72 часа и штрафы до 20 000 UTM. Обработчик, вышедший за рамки инструкций, отвечает как оператор данных — значит, каждый внешний подрядчик становится риском.
Теневые чат-боты у персонала
Врачи и администраторы, не дождавшись корпоративного решения, работали в потребительских чат-ботах на личных устройствах. Именно этого согласования и должны были не допустить, а служба комплаенса не видела, какие данные туда уходят.
03 — Возможности
Что делает система
Ключевые сценарии и рабочие модули, собранные в единую систему.
Периметр клинических данных
Узлы инференса, прикладные сервисы, поисковый индекс, объектное хранилище и база аудита находятся в одной сегментированной зоне дата-центра клиента. Исходящий трафик запрещён по умолчанию. Веса моделей и образы контейнеров попадают внутрь только через проверяемый канал поставки и закреплены по хешу: ни одной загрузки из интернета во время работы.
Приём сканов и диктовок
Большинство документов приходит не текстом, а сканами и аудиозаписями диктовок, и почти всё — на испанском. Tesseract OCR распознаёт сканы, Whisper, настроенный на диктовки самих врачей, переводит речь в текст. Дальше документы нормализуются, делятся на фрагменты, превращаются в эмбеддинги и индексируются локально. Данные движутся только в одну сторону.
Извлечение данных из направлений и выписок
Специализированная клиническая модель извлекает из направлений и выписных эпикризов диагнозы, препараты, дозировки и коды. У каждого поля есть ссылка на исходный фрагмент записи, поэтому сотрудник проверяет, а не принимает на веру. На неоднозначных записях модель не угадывает, а воздерживается от ответа, а идентификаторы пациента вычищаются ещё до записи в логи.
Доступ по принципу «нужно знать»
Права проверяются на этапе поиска, а не при выводе ответа. Каждый запрос к индексу несёт контекст полномочий сотрудника и отсекает документы до того, как они попадут в модель. Специалист, который не лечит пациента, не может получить его карту в запросе. Это решение прошло собственную проверку безопасности клиента без изменений.
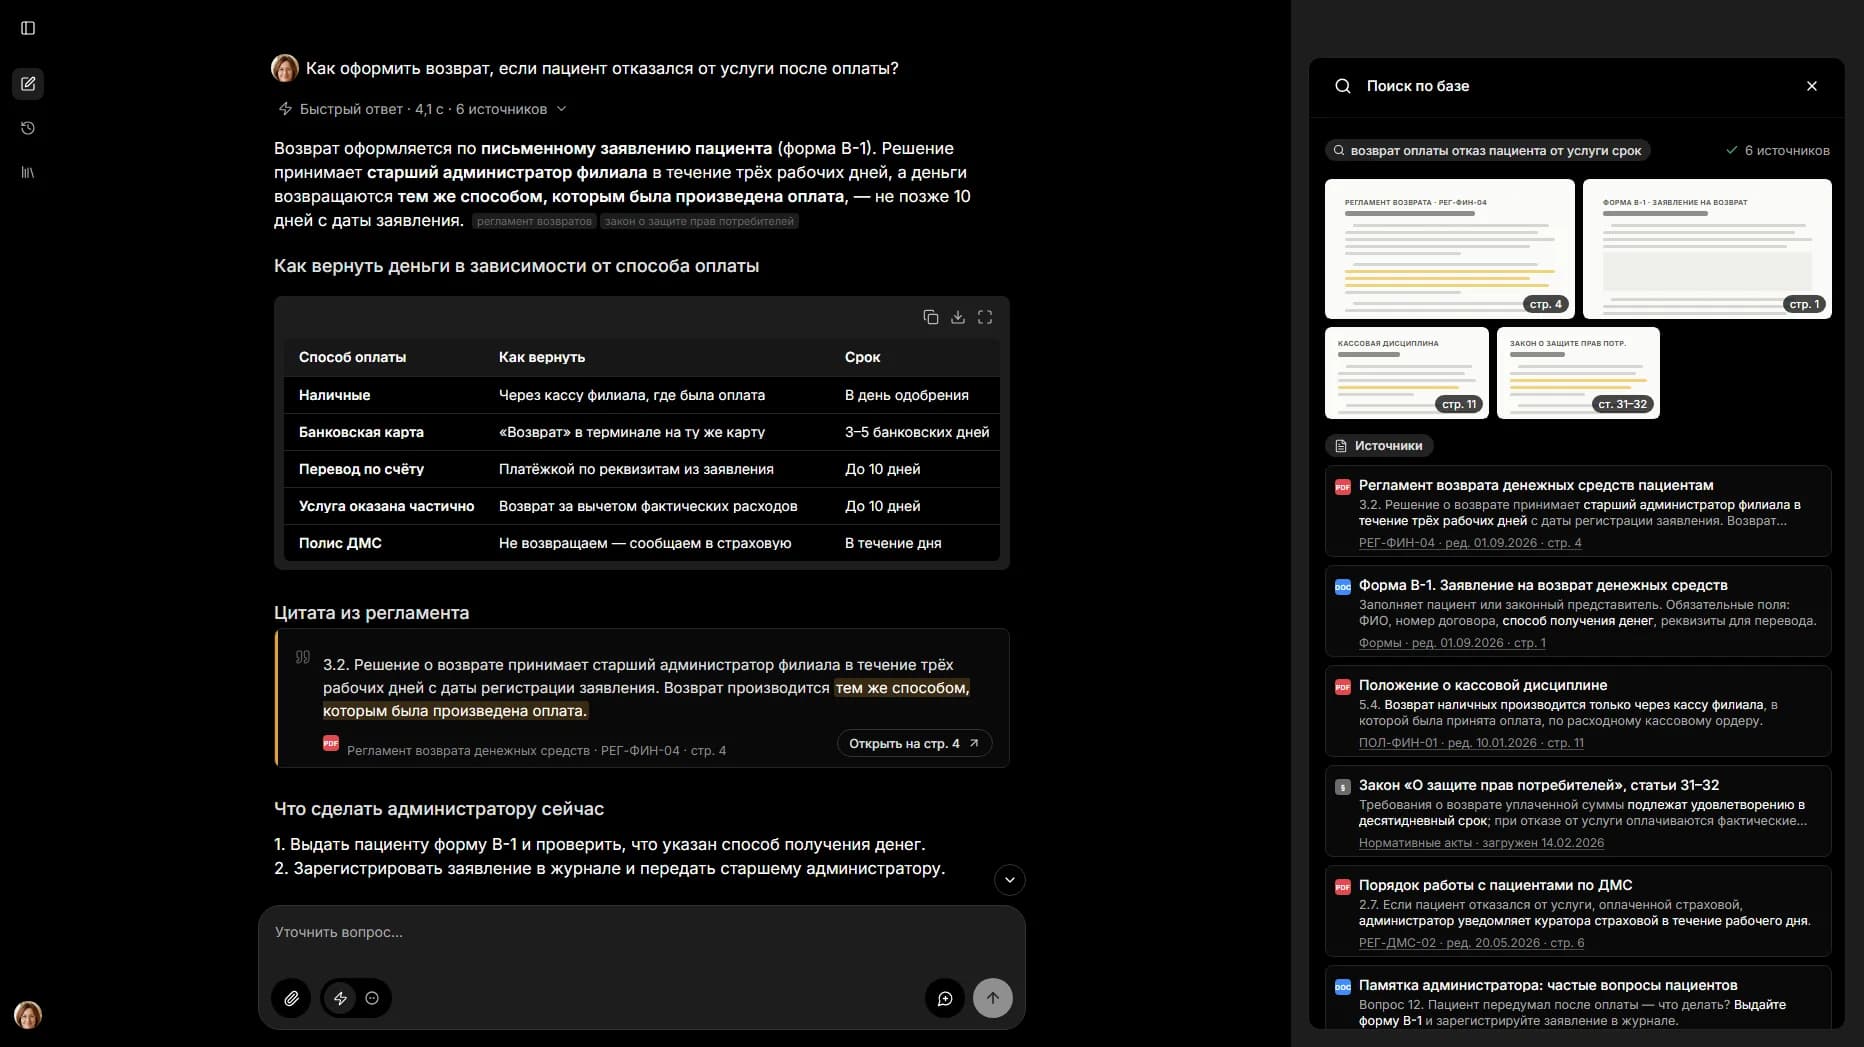
AI-пространство «Люмен» для персонала
Вместо вкладок с потребительскими чат-ботами сотрудники работают в нашем AI-пространстве «Люмен», развёрнутом внутри того же периметра. Вход через корпоративный SSO, рабочие пространства по ролям, администраторы видят активность. Для свободных задач — резюме и черновиков на испанском — работает Llama 3.3 70B, остальное закрывает специализированная модель.
Журнал доступа на 15 лет
Аудит хранится не в логах приложения, а в неизменяемых таблицах PostgreSQL: кто обратился, с какой целью, к какой записи, какая версия модели ответила, хеши запроса и ответа. Срок хранения совпадает с 15 годами хранения медкарты по Decreto 41. Сессии завершаются автоматически, а экстренный доступ (break-glass) описан и фиксируется отдельно.
Обезличивание для аналитики
Отдельный контур убирает прямые и косвенные идентификаторы из данных для аналитики и наборов для оценки моделей — по стандарту Ley 21.719: повторная идентификация разумными средствами должна быть невозможна. Мы сознательно не используем обезличивание как разрешение отправлять клинические тексты наружу: в свободных записях врачей остаются детали, которые шаблоны пропускают.
04 — Архитектура
Технологический стек
Технологии выбраны под нагрузку, интеграции и дальнейшее развитие продукта.
Зачем в проекте · 01 / 06
vLLM + NVIDIA H100
Одна среда исполнения для обеих моделей на двух узлах NVIDIA H100, размер которых рассчитан по замеренной пиковой нагрузке. Непрерывный батчинг и страничный KV-кеш держат нужное число одновременных запросов на фиксированном железе, а внешних эндпоинтов в цепочке нет. Команде эксплуатации клиента нужно сопровождать и обновлять одну систему.
- On-premise LLM
05 — Процесс
Как шла разработка
Последовательность работ от исследования задачи до запуска и проверки результата.
Недели 1–3: периметр
Сегментировали сеть, подняли GPU-узлы, подключили корпоративный провайдер учётных записей, настроили канал поставки моделей и хранилище аудита. Проверка комплаенса шла параллельно со сборкой, а не перед ней, — поэтому юристы не стали узким местом.
Недели 4–8: направления и поиск
Построили приём направлений — самого массового типа документов в сети — и подняли поиск. Модели и распознавание речи с самого начала отбирали и проверяли на испанских документах и диктовках клиента.
Недели 9–12: теневой режим
Система работала параллельно с привычным процессом на живом потоке вместе с центральной службой приёма пациентов. Результаты сверяли с отложенной выборкой, которую разметили врачи и администраторы самой сети.
Переключение по метрикам
Запуск привязали к качеству, а не к календарю: переключились, когда извлечение достигло согласованного порога, а журнал аудита был полным для каждого обращения к модели.
Выписные эпикризы
Второй задачей стали выписные эпикризы. Они используют тот же периметр, среду исполнения и хранилище аудита, поэтому новая работа свелась к приёму документов и оценке качества, а не к перестройке системы.
Передача команде клиента
Передачу планировали с первого дня: регламенты на обновление моделей и отказ узла, пересмотр мощностей по нагрузке и назначенный внутренний владелец канала поставки. Система, которую может обслуживать только подрядчик, — зависимость, которую клиент не заказывал.
06 — Итог
Результаты
Что создано в рамках проекта: рабочий контур, реализованные возможности и подтверждённые факты.
- внешних обработчиков клинических данных
- 0
- документов в месяц внутри периметра
- 45 тыс.
- точность извлечения из направлений
- F1 0,95
- на разбор одного направления
- 12 → 4 мин
Качество измеряли на документах клиента, а не по публичным рейтингам. На отложенной выборке, размеченной сотрудниками сети, извлечение из направлений к моменту запуска достигло F1 0,95 по полям, а 98 % утверждений ведут на реальное исходное предложение, которое можно открыть одним кликом. Разбор направления, на который вручную уходило около 12 минут, теперь занимает около 4: поля уже заполнены и сверены с источниками.
Главный результат — комплаенс. Около 45 000 документов в месяц обрабатываются без единого внешнего обработчика: не нужно заключать и пересматривать договоры до декабря 2026 года, нет цепочки субподрядчиков и трансграничной передачи данных. Полнота аудита — отслеживаемая метрика, служба комплаенса по своему графику проверяет отказы в доступе и экстренные входы. Работа персонала с ИИ переехала в «Люмен», где её видят администраторы.
Задержки p50 и p95 при целевой нагрузке укладываются в норму на двух фиксированных узлах. Разговор о стоимости запросов сменился разговором о мощностях — именно такого обмена клиент и добивался, соглашаясь на собственное оборудование.
Детали проекта
Почему кейс без имени клиента
Название медицинской сети мы не раскрываем. Для клиники сведения о потоке пациентов, внутренних процессах и устройстве защиты данных чувствительны сами по себе, поэтому закрытыми остаются имя клиента и всё, что позволяет его вычислить. Открыто можно сказать главное: это сеть специализированных медицинских центров в Чили — больше 30 клиник в нескольких регионах.
Как система устроена изнутри, мы рассказываем свободно: периметр данных, две модели на общей среде исполнения, контроль доступа на этапе поиска, журнал аудита и 12 недель до первой задачи в продакшене. Рекомендацию клиента можем предоставить по запросу под NDA.
FAQ
Вопросы о проекте
Далее
Похожие проекты
Обсудим похожий проект?
Расскажите о задачах вашего бизнеса — предложим архитектуру и оценим сроки


